
Crawl budget (budżet indeksowania) to liczba adresów URL, które Googlebot może i chce pobrać z witryny w danym czasie. Robot nie pobiera wszystkiego naraz: tempo ogranicza wydajność serwera, a kolejność wynika z tego, jak popularne i jak często zmieniane są adresy. Dla strony firmowej z kilkudziesięcioma podstronami crawl budget rzadko jest problemem. W sklepie z filtrami, w serwisie z tysiącami adresów albo po migracji błędy 404, przekierowania i duplikaty zużywają go bez efektu, a nowe strony czekają na indeksację tygodniami.
Co dokładnie oznacza crawl budget?
Crawl budget nie jest liczbą, którą widać w panelu, tylko wypadkową dwóch ograniczeń: ile żądań serwer obsłuży bez spowolnienia i ile adresów Google uważa za warte pobrania. Google opisuje to pojęcie w dokumentacji Search Central „Zarządzanie budżetem indeksowania w przypadku dużych witryn” i zastrzega, że dotyczy ono głównie serwisów z ponad milionem adresów albo powyżej 10 tys. adresów zmienianych codziennie.
Budżet obejmuje każde pobranie, nie tylko stron HTML. Googlebot pobiera także arkusze CSS, skrypty JavaScript i obrazy potrzebne do wyrenderowania strony (zobacz, czy Google widzi treść ładowaną przez JavaScript). W raporcie Statystyki indeksowania dla roseo.com.pl strony HTML to 46% żądań, pliki CSS 31%, a obrazy tylko 3%.
Crawlowanie (pobieranie) to pierwszy etap. Indeksowanie, czyli zapisanie strony w bazie Google, następuje później i nie dotyczy każdego pobranego adresu. Strona może być pobrana i nie trafić do indeksu, gdy Google uzna ją za duplikat lub treść niskiej jakości.
Crawl budget dotyczy pobierania stron, nie ich pozycji. Większy budżet nie podnosi strony w wynikach. Zbyt mały opóźnia pojawienie się nowych i zmienionych treści w Google.
Jak Google ustala crawl budget?
Google łączy dwa czynniki: limit szybkości indeksowania (crawl rate limit) i zapotrzebowanie na indeksowanie (crawl demand).
- Limit szybkości indeksowania: maksymalna liczba równoległych połączeń i odstęp między żądaniami, przy których serwer odpowiada bez spowolnienia. Gdy czas odpowiedzi rośnie lub pojawiają się błędy 5xx, Googlebot sam zwalnia. Gdy serwer odpowiada szybko, limit rośnie.
- Zapotrzebowanie na indeksowanie: ile adresów Google chce pobrać ponownie. Zależy od popularności adresu (linki, ruch) i od tego, jak często treść się zmienia. Strona odwiedzana rzadko i niezmieniana od roku jest pobierana rzadziej niż strona główna aktualizowana co tydzień.
W raporcie Statystyki indeksowania widać to w karcie „Według przeznaczenia”: na roseo.com.pl 74% żądań to odświeżenie znanych adresów, a 26% to wykrywanie nowych. Po przebudowie oferty w lipcu 2026 liczba żądań skoczyła z kilkunastu do 375 dziennie, bo pojawiło się kilkadziesiąt nowych adresów do pobrania.
Co zużywa crawl budget?
Crawl budget zużywa każde żądanie, które nie kończy się pobraniem strony wartej indeksacji. Najczęstsze źródła strat:
- Błędy 404: robot pobiera adres, dostaje odpowiedź „nie znaleziono” i wraca po kilku dniach, żeby sprawdzić ponownie. Co to jest błąd 404 i skąd się bierze, opisaliśmy w osobnym wpisie.
- Łańcuchy przekierowań: adres A przekierowuje na B, a B na C. Każde przekierowanie 301 w łańcuchu to osobne żądanie, a Googlebot przerywa łańcuch po kilku skokach.
- Duplikaty adresów: ta sama strona pod http i https, z www i bez, z ukośnikiem na końcu i bez, z wielkimi i małymi literami.
- Parametry URL i filtry: sortowanie, kolor, rozmiar, zakres ceny. Sklep z 200 produktami i pięcioma filtrami tworzy tysiące kombinacji adresów o tej samej treści.
- Soft 404: strona bez treści (pusta kategoria, „brak wyników”) zwracająca kod 200. Google pobiera ją jak zwykłą stronę i dopiero po analizie odrzuca. Czym dokładnie jest soft 404 i jak go naprawić, opisaliśmy w osobnym wpisie.
- Wolny serwer: przy czasie odpowiedzi powyżej sekundy Googlebot obniża limit szybkości. Na roseo.com.pl średni czas reakcji w ostatnich 90 dniach to 938 ms.
- Nieskończone przestrzenie adresów: kalendarze z linkiem „następny miesiąc”, wyniki wyszukiwarki wewnętrznej, identyfikatory sesji w adresie.
Jak sprawdzić crawl budget w Google Search Console?
Crawl budget sprawdzasz w trzech miejscach: w raporcie Statystyki indeksowania, w raporcie Strony i w logach serwera.
Statystyki indeksowania
Ustawienia → Statystyki indeksowania. 90 dni: liczba żądań, rozmiar pobrania, czas reakcji serwera oraz podział według odpowiedzi (200, 301, 404), typu pliku, przeznaczenia i typu Googlebota. Pełne wyjaśnienie każdej karty znajdziesz we wpisie jak czytać każdą kartę tego raportu. Bez dostępu? Zobacz, jak dodać użytkownika do Google Search Console.
Raport Strony
W raporcie Strony (Indeksowanie → Strony) wiersz „Strona wykryta – obecnie niezindeksowana” to adresy, które Google zna, ale jeszcze ich nie pobrał. Rosnąca liczba w tym wierszu to pierwszy sygnał, że budżet nie nadąża.
Logi serwera i crawler
Logi pokazują każdą wizytę Googlebota z adresem i kodem odpowiedzi. Screaming Frog SEO Spider wypisuje łańcuchy przekierowań i duplikaty, które robot napotka.
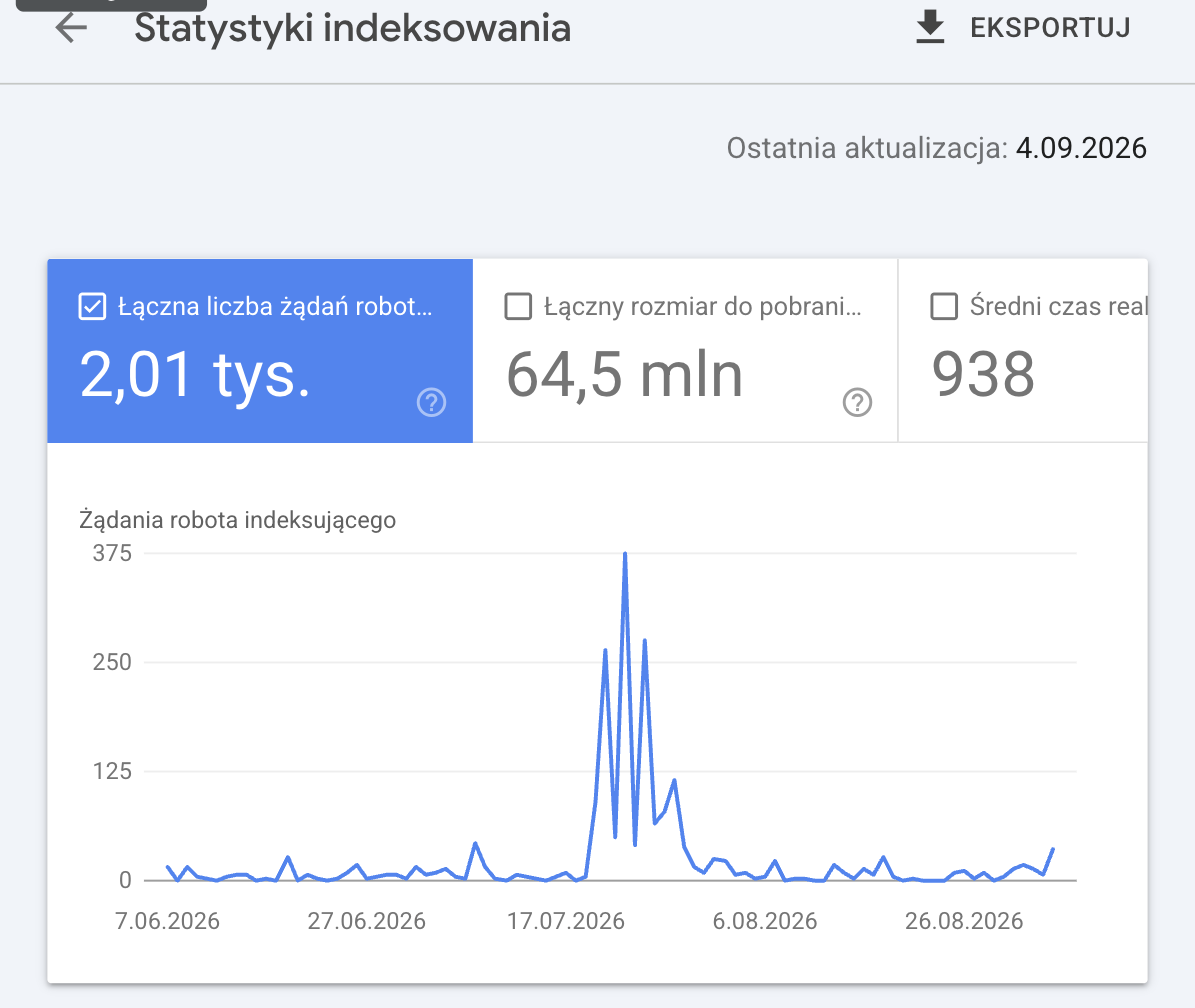
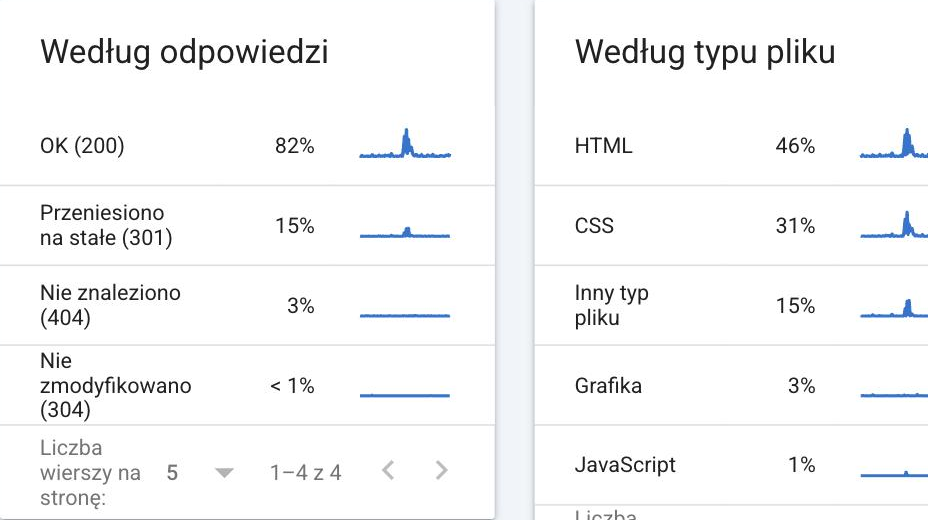
Przykład z roseo.com.pl (stan 4.09.2026): 2,01 tys. żądań w 90 dni, 64,5 MB pobranych danych, 938 ms średniego czasu reakcji. Według odpowiedzi 82% żądań kończy się kodem 200, 15% przekierowaniem 301, a 3% błędem 404. Te 15% to głównie adresy bez ukośnika na końcu, które WordPress przekierowuje na wersję z ukośnikiem: co szóste żądanie robota idzie na skok, którego dałoby się uniknąć spójnym linkowaniem wewnętrznym i jedną regułą przekierowania zamiast poprawiania linków pojedynczo.
Kiedy crawl budget ma znaczenie?
Crawl budget ma znaczenie wtedy, gdy Google nie nadąża z pobieraniem adresów, które mają być w indeksie. W małym serwisie firmowym robot pobiera wszystko w ciągu kilku dni i budżet nie jest ograniczeniem.
🚫 Kiedy crawl budget kosztuje
- ✕Ponad 10 tys. adresów albo treści zmieniane codziennie: portal, ogłoszenia, duży sklep.
- ✕Filtry i warianty produktów tworzą setki adresów z tą samą treścią.
- ✕Po migracji tysiące starych adresów przekierowują na nowe, często łańcuchami (stąd ważna mapa przekierowań przy zmianie domeny).
- ✕Wiersz „wykryta – obecnie niezindeksowana” w raporcie Strony rośnie z tygodnia na tydzień.
✅ Kiedy crawl budget nie ma znaczenia
- ✓Strona firmowa ma do kilkuset adresów, a nowe podstrony pojawiają się w Google w ciągu kilku dni.
- ✓Liczba adresów „wykryta – obecnie niezindeksowana” jest stała lub maleje.
- ✓Serwer odpowiada poniżej 500 ms i nie zwraca błędów 5xx.
Roseo.com.pl ma 240 adresów, z czego 237 jest zindeksowanych, a 46 adresów w raporcie Strony czeka jako „wykryta – obecnie niezindeksowana” (stan 28.08.2026). To nie jest brak budżetu, tylko kolejka po lipcowej przebudowie: robot dotrze do tych adresów bez żadnej zmiany na stronie.
Masz sklep z filtrami albo tysiące adresów, a nowe produkty długo nie pojawiają się w Google?
Wskażemy adresy, które zużywają budżet bez efektu, w ramach pozycjonowania sklepów internetowych.
Co zrobić, gdy robot marnuje budżet?
Kolejność działań wynika z tego, co pokazuje raport Statystyki indeksowania w karcie „Według odpowiedzi”.
Napraw 404 i skróć łańcuchy
Adresy z linkami przekieruj kodem 301 bezpośrednio na cel. Linki wewnętrzne popraw tak, żeby prowadziły od razu na adres docelowy.
Ogranicz filtry i parametry
Warianty tej samej treści dostają tag kanoniczny na wersję główną, adresy bez wartości tag noindex, a parametry generowane masowo blokadę w pliku robots.txt.
Uporządkuj mapę witryny XML
W sitemapie zostają tylko adresy, które mają być w indeksie i zwracają kod 200.
Przyspiesz serwer
Czas odpowiedzi poniżej 500 ms i cache dla stron podnoszą limit szybkości indeksowania.
Wzmocnij linkowanie wewnętrzne
Strony linkowane z menu i ze strony głównej są pobierane częściej niż strony osiągalne po pięciu kliknięciach.
Pełną instrukcję dla sklepów (filtry, fasety, parametry) znajdziesz we wpisie Jak zoptymalizować crawl budget w sklepie internetowym?.
Jakie pojęcia wiążą się z crawl budgetem?
- Googlebot: robot Google, który pobiera strony; w raporcie występuje jako wersja na smartfony (na roseo.com.pl 28% żądań), na komputery (17%) i jako pobieranie zasobów strony (25%).
- Crawlowanie a indeksowanie: crawlowanie to pobranie strony, indeksowanie to zapisanie jej w bazie wyszukiwarki; drugie nie następuje po każdym pierwszym.
- Błąd 404: odpowiedź „nie znaleziono”; robot ponawia próby i zużywa budżet bez efektu.
- Przekierowanie 301: stała zmiana adresu; pojedyncze 301 jest w porządku, łańcuch kilku 301 mnoży żądania.
- Soft 404: strona bez treści z kodem 200, którą Google odrzuca dopiero po pobraniu.
- Mapa witryny XML: plik z listą adresów do indeksacji, który podpowiada robotowi, co pobrać w pierwszej kolejności.
- Plik robots.txt: plik z regułami, które adresy robot ma pomijać; blokada zdejmuje adres z kolejki pobierania, ale nie usuwa go z indeksu.
- Tag kanoniczny: wskazanie wersji głównej wśród duplikatów.
Nie wiesz, czy Google dociera do wszystkich Twoich podstron?
Sprawdzimy raporty Search Console w ramach pozycjonowania stron.
FAQ
Nie bezpośrednio. Crawl budget decyduje o tym, jak szybko Google pobierze nową lub zmienioną stronę, a nie o tym, na której pozycji ją pokaże. Wpływ na pozycje pojawia się pośrednio, gdy ważne strony czekają tygodniami na pobranie.
Nie. Google w dokumentacji pisze, że serwis poniżej kilku tysięcy adresów jest zwykle pobierany w całości bez problemu. Wystarczy unikać błędów 404 w linkach wewnętrznych i łańcuchów przekierowań.
Tak, pośrednio. Szybszy serwer podnosi limit szybkości, a częściej aktualizowane i lepiej linkowane strony podnoszą zapotrzebowanie. W Search Console nie ma przycisku, który ustawia większy budżet; dawne narzędzie do ograniczania szybkości indeksowania Google wyłączyło w styczniu 2024 r.
Tak. Adresy zablokowane w robots.txt nie są pobierane, więc nie zużywają budżetu. Blokada nie usuwa jednak adresu z indeksu, jeśli prowadzą do niego linki; do tego służy tag noindex, który wymaga pobrania strony.
Zależy od popularności i częstości zmian. Strona główna aktywnego serwisu jest pobierana codziennie, a rzadko zmieniana podstrona raz na kilka tygodni. Datę ostatniego pobrania sprawdzisz w Search Console w narzędziu Sprawdzenie adresu URL.
Źródła
- Google Search Central, „Zarządzanie budżetem indeksowania w przypadku dużych witryn”: developers.google.com
- Pomoc Google Search Console, „Raport Statystyki indeksowania”: support.google.com/webmasters
- Google Search Central Blog, „What Crawl Budget Means for Googlebot” (2017): developers.google.com/search/blog

