
Tag noindex to dyrektywa dla robotów wyszukiwarek: nie umieszczaj tej strony w indeksie. Zapisuje się ją w znaczniku <meta name="robots" content="noindex"> w sekcji <head> strony albo w nagłówku HTTP X-Robots-Tag. Strona dalej działa dla użytkownika, ale nie pojawia się w wynikach Google. Noindex trafia najczęściej na wyniki wyszukiwania wewnętrznego, strony z filtrami i strony techniczne, a efekt widać w raporcie Strony w Google Search Console.
Jak działa tag noindex?
Dyrektywa noindex to wartość, którą robot odczytuje po pobraniu strony. Jeśli ją znajdzie, nie dodaje adresu do indeksu, a jeśli strona jest już w indeksie, usuwa ją przy kolejnej wizycie. Bez tej dyrektywy każda pobrana strona jest kandydatem do indeksu, bo domyślnie obowiązuje index.
Znacznik ma dwie postacie. Pierwsza to meta robots w kodzie HTML strony:
<meta name="robots" content="noindex">
Druga to nagłówek odpowiedzi HTTP X-Robots-Tag: noindex, który serwer wysyła razem z plikiem. Obie znaczą to samo, różnią się tylko miejscem zapisu: znacznik meta działa wyłącznie w dokumentach HTML, a nagłówek przy każdym typie pliku.
Warunek działania jest jeden: robot musi pobrać stronę i odczytać znacznik. Pobranie strony (crawlowanie) i dodanie jej do indeksu to dwa osobne etapy, które opisaliśmy we wpisie Crawlowanie a indeksowanie: czym się różnią?. Noindex steruje drugim etapem, więc strona, której robot nie może pobrać, nie zostanie wykluczona tym znacznikiem.
Kiedy stosować noindex?
Noindex ustawiasz na stronach, które mają istnieć dla użytkownika, ale nie mają konkurować w wynikach wyszukiwania. Typowe przypadki:
- Wyniki wyszukiwania wewnętrznego. Każde zapytanie wpisane przez użytkownika tworzy nowy adres z tą samą listą produktów lub wpisów, ułożoną w innej kolejności.
- Strony z parametrami i filtrami. Sortowanie oraz filtr koloru czy rozmiaru mnożą adresy, pod którymi widać tę samą kategorię.
- Strony techniczne. Koszyk, logowanie, panel klienta czy strona „dziękujemy za zamówienie” istnieją i odpowiadają kodem 200, w odróżnieniu od adresu, którego nie ma, czyli błędu 404.
- Wersje robocze i środowisko testowe. Kopia strony do testów nie może pojawiać się w Google obok wersji produkcyjnej.
- Strony z cienką lub powieloną treścią. Do tej grupy trafiają archiwa tagów z jednym wpisem, strony autora bez opisu i paginacja archiwów o niskiej wartości.
Ten ostatni punkt dotyczy słabych archiwów, nie zwykłej paginacji kategorii produktów: strony /page/2/, /page/3/ kategorii mają różne produkty, więc noindex je odcina od wyszukiwarki niepotrzebnie. Zobacz, kiedy nie stawiać noindex na paginacji.
Noindex porządkuje indeks, ale nie oszczędza pobrań, bo robot i tak musi wejść na stronę, żeby odczytać dyrektywę. Jeśli problemem jest liczba adresów, które robot odwiedza, zacznij od wpisu Co to jest crawl budget?.
Jak ustawić noindex w Rank Math i w kodzie?
W WordPressie z wtyczką Rank Math noindex ustawiasz jednym checkboxem w panelu wpisu, bez edycji kodu. Ścieżka wygląda tak:
Edycja
Otwórz edycję wpisu lub strony.
Panel Rank Math
W prawym panelu wybierz „Rank Math SEO”.
Zakładka Zaawansowane
Przejdź do zakładki „Zaawansowane”.
Dane dla robotów
W sekcji „Dane dla robotów” zaznacz checkbox „No Index”.
Zapis
Zapisz wpis lub stronę.
Domyślnie w tej sekcji zaznaczone jest pole „Indeks”, czyli robot może stronę zindeksować. Etykieta „No Index” zostaje po angielsku mimo polskiego interfejsu: obok niej po polsku są „Indeks”, „Brak archiwum” i „Brak fragmentu”, a po angielsku „Nofollow” i „No Image Index”. Jeśli szukasz w panelu polskiej etykiety „brak indeksu”, nie znajdziesz jej.
Bez wtyczki znacznik <meta name="robots" content="noindex"> dodajesz w sekcji <head> szablonu strony. Pliki bez tej sekcji, na przykład PDF albo obrazy, można wykluczyć tylko nagłówkiem X-Robots-Tag: noindex ustawionym w konfiguracji serwera.
Jak sprawdzić noindex w Google Search Console?
Strony wykluczone dyrektywą noindex widzisz w raporcie Indeksowanie → Strony, w tabeli „Dlaczego strony nie są zindeksowane”, w wierszu „Strona wykluczona za pomocą tagu „noindex””. W kolumnie Źródło ten wiersz ma wartość „Strona internetowa”, czyli o wykluczeniu zadecydowała witryna, a nie systemy Google.
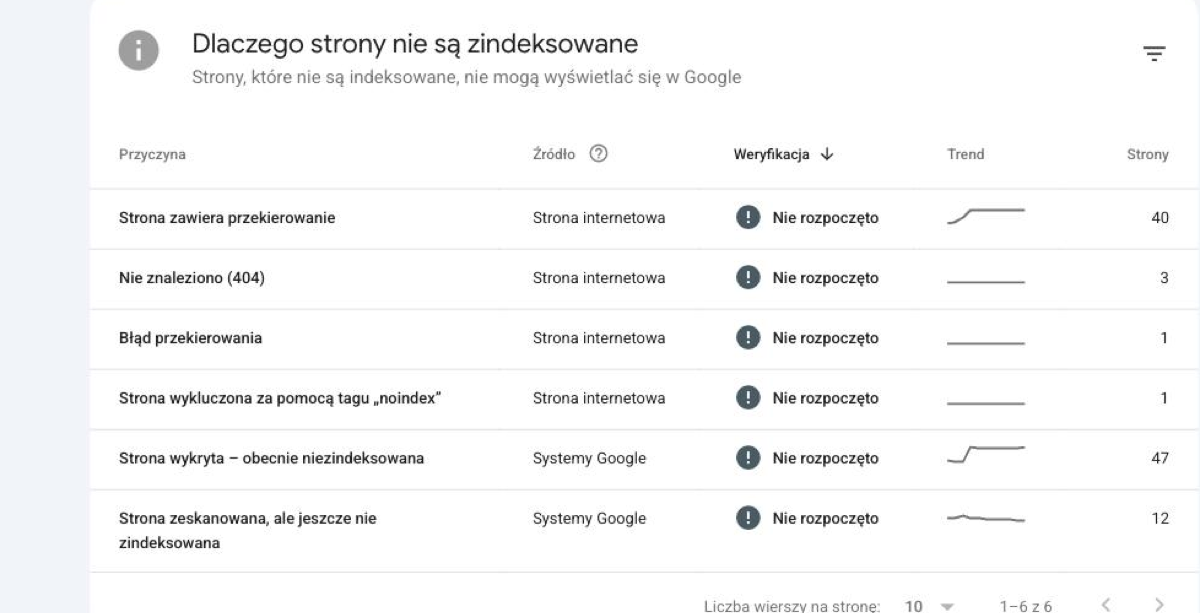
W danych z panelu roseo.com.pl ten wiersz pokazuje jedną stronę. Gdy klikniesz ten wiersz, Search Console wyświetla listę adresów. To właściwy moment na kontrolę: każdy adres na tej liście ma być wykluczony celowo. Adres, który miał być w Google, a znalazł się na tej liście, to sygnał, że noindex ustawiono przez pomyłkę.
Pojedynczy adres sprawdzisz w narzędziu Sprawdzenie adresu URL, które podaje, czy indeksowanie strony jest dozwolone, i wskazuje dyrektywę, która je blokuje.
Jakie są typowe błędy z noindex?
Dwa błędy powtarzają się najczęściej: noindex razem z blokadą w pliku robots.txt oraz noindex zostawiony po wdrożeniu strony ze środowiska testowego.
Błąd 1: noindex i blokada w robots.txt na tej samej stronie. Taka blokada zatrzymuje pobranie strony, więc robot nie widzi znacznika noindex. Jeśli prowadzą do niej linki, Google może ją zindeksować bez treści, na podstawie samego adresu i tekstu linków.
Strona jednocześnie zablokowana w robots.txt i oznaczona noindex zostaje w indeksie, bo robot jej nie pobiera i nie widzi znacznika. Google nie obsługuje też reguły noindex wpisanej bezpośrednio do pliku robots.txt. Do usunięcia strony z indeksu służy znacznik noindex w jej kodzie albo nagłówek X-Robots-Tag, a dostęp w robots.txt trzeba zostawić otwarty, dopóki robot nie odczyta dyrektywy.
Różnicę między blokadą pobierania a wykluczeniem z indeksu, razem z tabelą Disallow, Allow i noindex, opisaliśmy we wpisie Co to jest plik robots.txt?.
Błąd 2: noindex zostawiony po wdrożeniu. Środowisko testowe ma noindex ustawiony w całej witrynie, przez wtyczkę SEO albo przez opcję WordPressa w Ustawienia → Czytanie → Widoczność w wyszukiwarkach → „Proś wyszukiwarki o nieindeksowanie witryny”. Po przeniesieniu na domenę produkcyjną opcja zostaje zaznaczona, a strona wypada z wyników, mimo że miała być publiczna.
Dlatego po wdrożeniu lub migracji warto sprawdzić dwie rzeczy: czy w kodzie źródłowym strony głównej nie został znacznik noindex i co po kilku dniach od startu pokazuje raport Strony w Search Console.
Masz strony z noindex, które miały być w Google?
Napisz do nas, sprawdzimy to i podpowiemy, co zrobić.
Czym noindex różni się od pojęć powiązanych?
Noindex dotyczy tylko obecności strony w indeksie. Pojęcia sąsiednie sterują linkami, pobieraniem albo wyborem wersji głównej:
- Nofollow: dyrektywa, która mówi robotowi, żeby nie podążał za linkami; nie wpływa na indeksowanie samej strony, ale można ją połączyć z noindex (
noindex, nofollow). - Plik robots.txt: blokuje pobranie strony, nie usuwa jej z indeksu; adres, do którego prowadzą linki, może zostać zindeksowany bez treści.
- Tag canonical: noindex wyklucza stronę z indeksu, a canonical żadnej strony nie wyklucza, tylko wskazuje wśród duplikatów wersję główną i scala na niej sygnały.
- Soft 404: strona bez treści, którą Google sam klasyfikuje jako błąd; noindex to świadoma decyzja właściciela, a soft 404 efekt niezamierzony. Więcej we wpisie Co to jest soft 404?.
- Narzędzie „Usunięcia” w Search Console: doraźnie ukrywa adres w wynikach na około sześć miesięcy i nie zastępuje noindex.
Pozostałe pojęcia z tego obszaru zbieramy na blogu Roseo.
Nie wiesz, które strony wykluczyć z indeksu, a które zostawić?
Napisz do nas, przejrzymy raport Strony w Search Console i wskażemy listę.
FAQ
Strona znika po kolejnym pobraniu przez robota, czyli od kilku dni do kilku tygodni, zależnie od tego, jak często odwiedza on dany adres. Zgłoszenie adresu w Search Console (Sprawdzenie adresu URL → Poproś o zindeksowanie) przyspiesza ponowne pobranie i odczytanie dyrektywy.
Noindex nie blokuje podążania za linkami na stronie; do tego służy osobna dyrektywa nofollow. Strona z noindex może więc dalej prowadzić robota do innych adresów, tylko sama nie trafia do indeksu.
Nie. Narzędzie „Usunięcia” ukrywa adres w wynikach na około sześć miesięcy i służy do pilnych przypadków. Trwale wyklucza stronę z indeksu tylko znacznik noindex, nagłówek X-Robots-Tag albo skasowanie strony tak, żeby odpowiadała kodem 404 lub 410.
Tak, ale tylko przez nagłówek HTTP X-Robots-Tag: noindex, bo plik PDF ani obraz nie mają sekcji <head>, w której można umieścić znacznik meta. Ustawia się go w konfiguracji serwera dla wybranych plików lub katalogów.
Źródła
- Google Search Central, „Poznaj tag meta robots i nagłówek HTTP X-Robots-Tag”: developers.google.com
- Google Search Central, „Blokowanie indeksowania w wyszukiwarce za pomocą reguły noindex”: developers.google.com
- Google Search Console, pomoc, raport „Strony”: support.google.com/webmasters
- Google Search Console, pomoc, narzędzie „Usunięcia”: support.google.com/webmasters

