Crawlowanie to pobranie strony przez robota Google (Googlebota): robot wchodzi na adres i zapisuje kopię jego treści. Indeksowanie to późniejsza analiza tej kopii i decyzja, czy zapisać stronę w indeksie, czyli bazie, z której Google dobiera wyniki wyszukiwania. Strona może być pobrana i nie zostać zindeksowana; raport Strony w Search Console ma dla obu etapów osobne statusy.
Czym różni się crawlowanie od indeksowania?
Crawlowanie odpowiada na pytanie, czy Google ma treść strony; indeksowanie na pytanie, czy tę treść zapisał i może pokazać w wynikach. Kolejność jest stała: odkrycie adresu (z linku, mapy witryny lub zgłoszenia), pobranie, ocena i zapis w indeksie, a dopiero przy zapytaniu użytkownika ranking.
Podczas crawlowania Googlebot wysyła żądanie HTTP, pobiera HTML i zasoby potrzebne do wyrenderowania strony (CSS, JavaScript, obrazy, w tym zasoby ładowane leniwie); efektem jest kopia strony z chwili pobrania. O tym, jak wygląda renderowanie strony z JavaScriptem, piszemy w osobnym wpisie. W aplikacjach jednostronicowych ten etap bywa najtrudniejszy – jak pozycjonować aplikację jednostronicową opisujemy osobno. Podczas indeksowania systemy Google analizują tę kopię: tekst, znaczniki, atrybuty obrazów i wideo, duplikaty i adres kanoniczny, i decydują, czy zapisać ją w indeksie. Strona pobrana bez błędu może zostać poza indeksem.
| Crawlowanie | Indeksowanie | |
|---|---|---|
| Co się dzieje | Googlebot pobiera adres i jego zasoby | systemy Google analizują pobraną kopię i zapisują ją w indeksie albo nie |
| Co o tym decyduje | dostępność adresu: odpowiedź serwera, reguły robots.txt, kolejka pobierania | ocena treści: duplikaty, adres kanoniczny, znacznik noindex, jakość |
| Efekt | kopia strony u Google | strona może pojawić się w wynikach wyszukiwania |
| Gdzie widać w Search Console | Sprawdzenie adresu URL (data pobrania), raport Statystyki indeksowania | raport Strony, Sprawdzenie adresu URL (decyzja o indeksacji, adres kanoniczny) |
Limit pobrań, czyli crawl budget, dotyczy wyłącznie pierwszego etapu i nie zmienia decyzji o indeksacji ani pozycji w wynikach.
Jak różnicę widać w raporcie Strony w Search Console?
Raport Strony (Indeksowanie → Strony) zalicza każdy znany Google adres do jednej z dwóch grup, zindeksowane albo niezindeksowane, a przy niezindeksowanych podaje przyczynę i jej źródło. Dla roseo.com.pl 16 września 2026 r. raport pokazywał 234 zindeksowane i 104 niezindeksowane adresy, z sześcioma przyczynami.
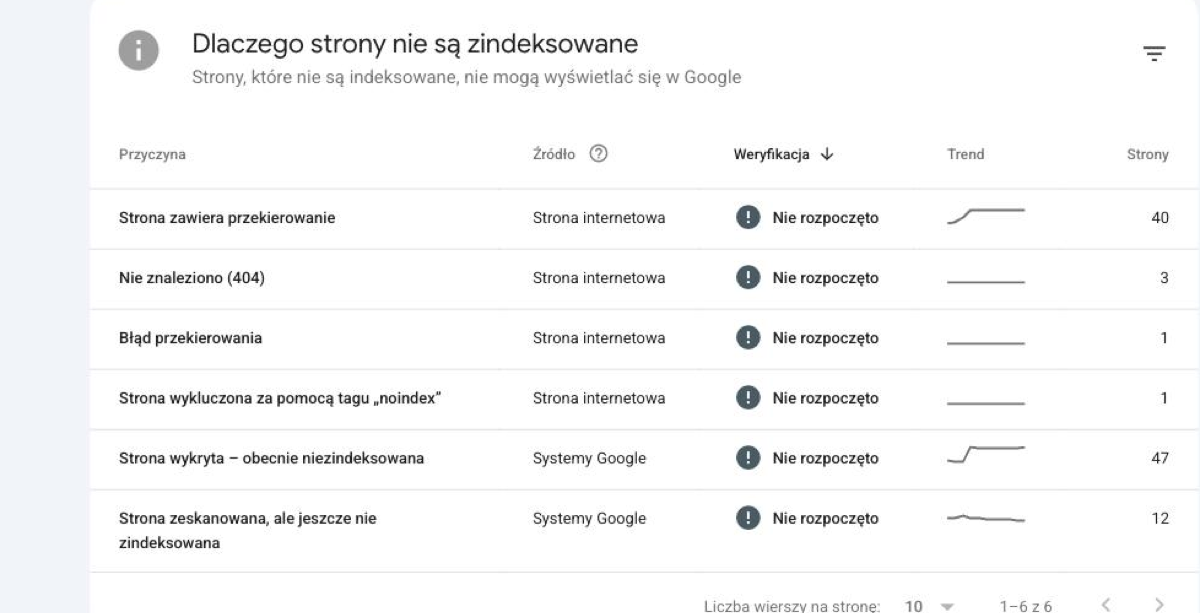
| Przyczyna | Źródło | Liczba stron |
|---|---|---|
| Strona zawiera przekierowanie | Strona internetowa | 40 |
| Nie znaleziono (404) | Strona internetowa | 3 |
| Błąd przekierowania | Strona internetowa | 1 |
| Strona wykluczona za pomocą tagu „noindex” | Strona internetowa | 1 |
| Strona wykryta – obecnie niezindeksowana | Systemy Google | 47 |
| Strona zeskanowana, ale jeszcze nie zindeksowana | Systemy Google | 12 |
Kolumna „Źródło” rozdziela oba procesy. Przy czterech przyczynach ze źródłem „Strona internetowa” (45 adresów) o wyniku zdecydowała odpowiedź witryny: przekierowanie, kod 404, błąd przekierowania lub znacznik noindex. Googlebot nie dostał treści do oceny albo dostał z nią instrukcję, żeby jej nie indeksować; systemy Google nie podejmowały decyzji. Przy dwóch przyczynach ze źródłem „Systemy Google” (59 adresów) witryna nie zwróciła błędu: pobranie czeka w kolejce albo już się odbyło, a stan wynika z harmonogramu i decyzji Google.
Liczby żądań robota pokazuje inny raport Search Console, Statystyki indeksowania; raport Strony pokazuje wynik obu etapów dla każdego adresu.
Raport Strony pokazuje dużo niezindeksowanych adresów?
Sprawdzimy, które przyczyny wymagają zmian na stronie.
Czym różni się status „wykryta – obecnie niezindeksowana” od „zeskanowana, ale jeszcze nie zindeksowana”?
Różnica to jeden etap: przy „Strona wykryta – obecnie niezindeksowana” Google zna adres, ale jeszcze go nie pobrał; przy „Strona zeskanowana, ale jeszcze nie zindeksowana” strona została pobrana, a decyzja o indeksacji jeszcze nie zapadła.
„Wykryta – obecnie niezindeksowana” oznacza, że adres trafił do Google z mapy witryny, linku lub zgłoszenia i czeka w kolejce pobierania; według pomocy Search Console zwykle Google zaplanował pobranie i przełożył je, żeby nie obciążać serwera. Na roseo.com.pl w tym stanie jest 47 adresów, których treści Google jeszcze nie ma.
„Zeskanowana, ale jeszcze nie zindeksowana” oznacza, że Googlebot pobrał stronę, ale systemy Google nie zapisały jej w indeksie: czeka na ocenę albo została na razie odłożona. Może zostać zindeksowana później lub nie, a ponowne zgłoszenie nie jest wymagane. Na roseo.com.pl dotyczy to 12 adresów.
W jednym raporcie 47 adresów nie przeszło pierwszego etapu, a 12 przeszło pierwszy i czeka na drugi: pobranie i zapis w indeksie to dwa zdarzenia w różnym czasie.
Dlaczego strona bywa pobrana, ale niezindeksowana?
Bo indeksowanie to ocena treści, nie potwierdzenie pobrania: Google zapisuje strony, które uzna za odrębne i o wystarczającej jakości, a pomija pozostałe. Dokumentacja Google wymienia cztery sytuacje:
- Duplikat: treść pokrywa się z inną stroną, a Google wybrał inny adres kanoniczny.
- Treść zbyt uboga lub niskiej jakości: mało własnego tekstu, strona generowana automatycznie.
- Wykluczenie przez właściciela: tag noindex albo blokada w robots.txt, przez którą robot nie pobiera treści do oceny.
- Kolejka: strona pobrana po dużej publikacji albo przebudowie czeka na ocenę; to stan przejściowy, widoczny jako „zeskanowana, ale jeszcze nie zindeksowana”.
Strony są pobierane, ale nie trafiają do indeksu?
Ustalimy przyczynę dla konkretnych adresów.
FAQ
Nie ma stałego czasu. Według dokumentacji Google pobranie po zgłoszeniu adresu trwa od kilku dni do kilku tygodni, a indeksowanie następuje po nim, w osobnej kolejce.
Nie. Robots.txt zatrzymuje crawlowanie: robot nie pobiera adresu. Adres z linkami z innych stron może mimo to trafić do indeksu bez treści, ze statusem „Zindeksowano, ale zablokowano przez plik robots.txt”. Z indeksu wyklucza znacznik noindex, który robot musi móc pobrać.
Sprawdzić treść, nie pobieranie, bo pobranie już się odbyło: czy strona nie powiela innej, ile ma własnego tekstu i czy prowadzą do niej linki wewnętrzne. Po zmianach można zgłosić adres w Sprawdzeniu adresu URL; zgłoszenie bez zmian nie jest wymagane.
Źródła
- Google Search Central, „Jak działa wyszukiwarka Google”: developers.google.com
- Pomoc Google Search Console, „Raport Indeksowanie stron”: support.google.com/webmasters
- Google Search Central, „Zarządzanie budżetem indeksowania”: developers.google.com
- Google Search Central, „Zgłaszanie do Google prośby o ponowne zindeksowanie witryny”: developers.google.com