
Sprawdzenie adresu URL (w pomocy Google: narzędzie do sprawdzania adresów URL) pokazuje stan jednej strony w indeksie Google: czy jest zindeksowana, kiedy robot ją ostatnio pobrał i którą wersję uznał za kanoniczną. Uruchamiasz je z pola na górze Search Console, wpisując adres ze swojej usługi. Karta wyniku ma pięć elementów: werdykt, sekcję Indeksowanie stron, podgląd zindeksowanej strony, test na żywo i prośbę o zindeksowanie. Werdykt opisuje ostatnie skanowanie, a nie stan strony w tej chwili – i z przeoczenia tej różnicy bierze się większość błędnych wniosków.
Do czego służy narzędzie Sprawdzenie adresu URL i gdzie je znaleźć?
Narzędzie odpowiada na pytanie o jeden konkretny adres: czy jest w Google i dlaczego. Otwierasz je w Search Console na dwa sposoby: wklejasz pełny adres w pole wyszukiwania na górze każdego raportu albo klikasz pozycję Sprawdzenie adresu URL w menu bocznym, pod Skutecznością.
Adres musi należeć do usługi, w której pracujesz. Dla usługi typu prefiks URL (np. https://roseo.com.pl/) narzędzie przyjmie tylko adresy zaczynające się od tego prefiksu, a dla usługi domenowej każdy adres w tej domenie i jej subdomenach. Przycisk Poproś o zindeksowanie działa tylko dla właściciela usługi albo pełnego użytkownika, co ma znaczenie, gdy dodajesz do Search Console osobę z agencji.
Po wpisaniu adresu Google odczytuje jego stan z indeksu, co trwa kilka sekund. Wynik dotyczy wyłącznie tego jednego adresu: wersja z ukośnikiem na końcu, z parametrem albo pod http:// jest dla narzędzia osobną stroną.
Co oznaczają trzy werdykty na górze karty?
Werdykt w nagłówku karty mówi, czy adres jest w indeksie Google, a więc czy w ogóle może pojawić się w wynikach wyszukiwania. Pomoc Google opisuje trzy warianty:
- Adres URL znajduje się w Google: strona jest zindeksowana i może wyświetlać się w wynikach, o ile nie dotyczą jej ręczne działania ani prośba o usunięcie. Kafelek Indeksowanie stron pokazuje „Strona jest w indeksie”.
- Adres URL znajduje się w Google, ale występują związane z nim problemy: strona jest w indeksie, ale narzędzie wykryło błędy w ulepszeniach, np. w danych strukturalnych. W wynikach wyszukiwania strona pokazuje się normalnie, brakuje tylko elementów rozszerzonych.
- Adres URL nie znajduje się w Google: strony nie ma w indeksie i nie może wyświetlać się w wynikach. Kafelek Indeksowanie stron podaje przyczynę, np. „Adres URL jest Google nieznany” albo „Strona wykluczona za pomocą tagu noindex”.
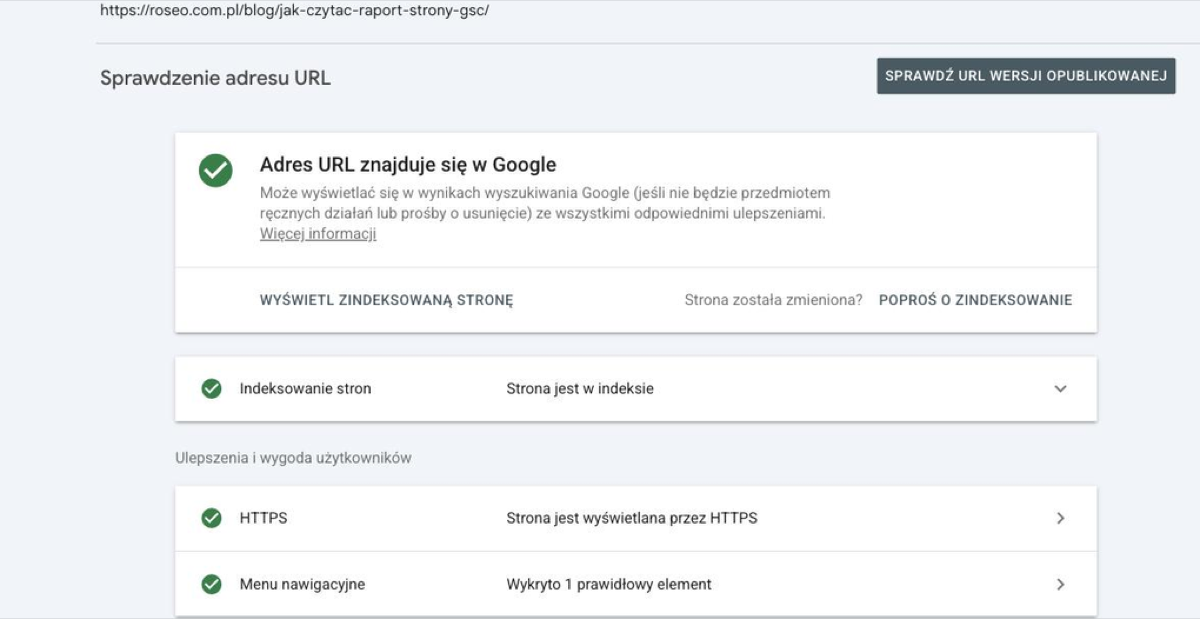
Zindeksowanie nie jest tym samym, co widoczność: zielony werdykt mówi tylko tyle, że strona może trafić do wyników, a nie że realnie pokazuje się na jakąkolwiek frazę. Pozycje i kliknięcia sprawdzasz w raporcie Skuteczność, nie tutaj.
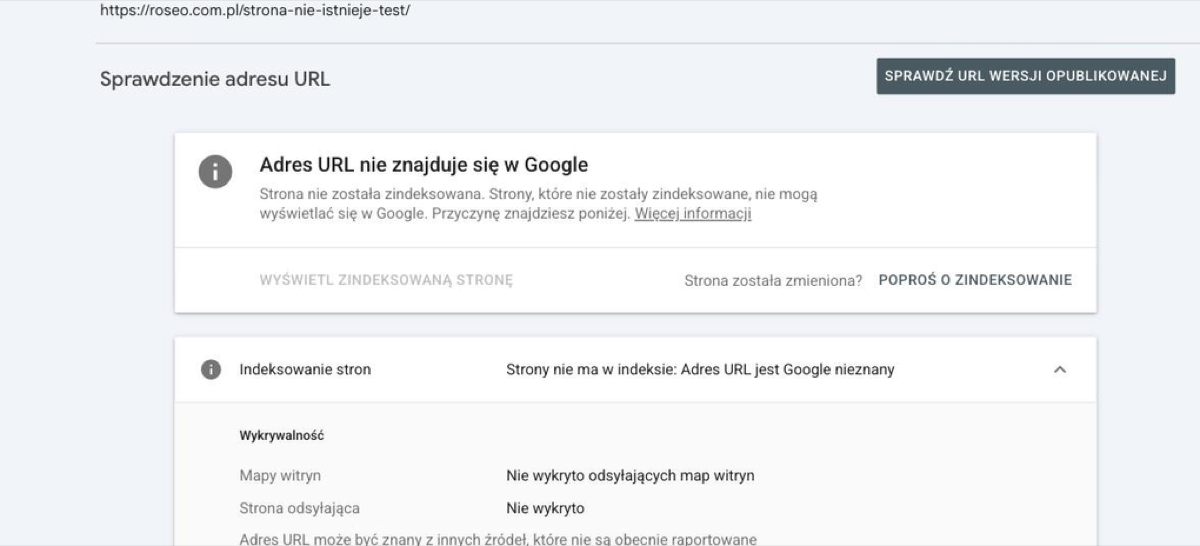
Na drugim zrzucie sprawdzamy adres, który na roseo.com.pl celowo zwraca błąd 404. Google nigdy do niego nie dotarł, więc przycisk Wyświetl zindeksowaną stronę jest nieaktywny, a w sekcji Wykrywalność oba pola mają wartość „Nie wykryto”. Dla adresu spoza indeksu narzędzie pokazuje zawsze ten sam nagłówek, a nazwę przyczyny znajdziesz w kafelku niżej; co znaczą poszczególne przyczyny i które wymagają naprawy, opisuje wpis o raporcie Strony.
Jak czytać sekcję Indeksowanie stron?
Sekcja Indeksowanie stron (rozwijasz ją strzałką po prawej) to protokół z ostatniej wizyty Google pod tym adresem, podzielony na trzy grupy: skąd Google zna adres, jak go pobrał i którą wersję zapisał. Dla adresu spoza indeksu rozwija się sama.
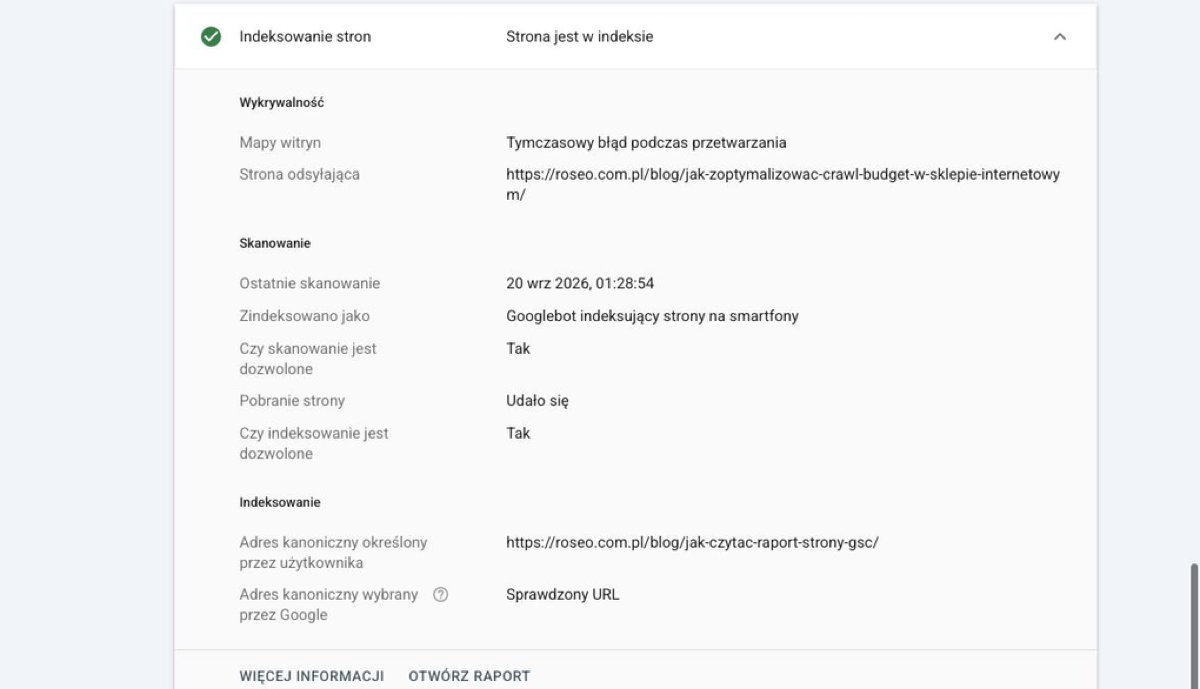
Wykrywalność mówi, skąd Google wie o stronie. „Mapy witryn” wskazuje przesłaną mapę witryny XML, w której jest adres; na zrzucie pole pokazuje „Tymczasowy błąd podczas przetwarzania”, a ten komunikat dotyczy mapy, nie strony – adres i tak jest w indeksie. „Strona odsyłająca” to miejsce, z którego Google trafił na ten adres po raz pierwszy; u nas jest nim inny wpis z bloga, linkujący do sprawdzanego adresu. Nowa podstrona bez linków wewnętrznych i bez mapy witryny ma w obu polach „Nie wykryto” i taki adres Google odkrywa najdłużej.
Skanowanie opisuje samo pobranie. „Ostatnie skanowanie” to data i godzina, z której pochodzi cała reszta karty. „Zindeksowano jako” podaje typ robota, zwykle „Googlebot indeksujący strony na smartfony”, bo Google ocenia strony w wersji mobilnej. „Czy skanowanie jest dozwolone” odnosi się do reguł w pliku robots.txt, „Pobranie strony” do odpowiedzi serwera (Udało się, błąd, przekierowanie), a „Czy indeksowanie jest dozwolone” do tagu noindex w kodzie albo w nagłówku HTTP. Te trzy pola razem tłumaczą, dlaczego pobrana strona nie zawsze trafia do indeksu, o czym więcej we wpisie o różnicy między crawlowaniem a indeksowaniem.
Indeksowanie zestawia dwa adresy kanoniczne: „określony przez użytkownika”, czyli z Twojego tagu canonical, i „wybrany przez Google”. Wartość „Sprawdzony URL” przy drugim polu oznacza zgodę obu stron: Google uznał sprawdzany adres za główną wersję. Inny adres w tym polu oznacza, że Google zignorował Twoją deklarację i w wynikach pokazuje tamtą stronę, a sprawdzaną traktuje jako duplikat.
Dlaczego werdykt opisuje ostatnie skanowanie, a nie stan na żywo?
Wszystko, co widzisz w widoku Indeks Google, pochodzi z chwili podanej w polu „Ostatnie skanowanie”, bo Google pokazuje tu swoją zapisaną kopię strony, a nie pobiera jej na nowo. Jeśli od tamtej wizyty zmieniłeś stronę, werdykt opisuje wersję sprzed zmiany.
Ta różnica potrafi kosztować niepotrzebną pracę. Prowadzimy wspólną kolejkę adresów do zgłoszenia z wielu witryn i sprawdzamy stan każdego z nich tym samym narzędziem, tyle że w wersji API. Pewnego dnia cztery świeżo opublikowane strony dostały werdykt „Strona wykluczona za pomocą tagu noindex”, choć na żywo zwracały kod 200 i index, follow. Ostatnie skanowanie było z nocy przed publikacją, a domenę kupiliśmy z drugiej ręki, więc Google opisywał treść poprzedniego właściciela. Gdybyśmy uwierzyli werdyktowi, zaczęlibyśmy naprawiać noindex, którego nie było.
Zanim wyciągniesz wniosek z werdyktu, porównaj datę w polu „Ostatnie skanowanie” z datą swojej ostatniej zmiany na stronie. Skanowanie starsze niż zmiana oznacza, że Google jeszcze jej nie widział, i wtedy o stanie strony mówi tylko test na żywo.
To samo dotyczy przeciwnego przypadku: strona z zielonym werdyktem, którą wczoraj ktoś przez pomyłkę zablokował w robots.txt, będzie „w Google” aż do następnego pobrania. Data skanowania jest więc pierwszą rzeczą do sprawdzenia przy każdym adresie, nie ostatnią.
Strona zniknęła z Google albo nie wchodzi do indeksu i nie wiesz, czy to Twoja wina, czy Google jeszcze nie wrócił?
Napisz do nas, sprawdzimy adres w Search Console i podpowiemy, co zrobić.
Co pokazuje Wyświetl zindeksowaną stronę?
Przycisk Wyświetl zindeksowaną stronę otwiera panel „Zindeksowana strona” z kopią, którą Google zapisał przy ostatnim skanowaniu, czyli dokładnie tym, co jest w indeksie. Panel ma trzy zakładki: HTML, Zrzut ekranu i Więcej informacji.
Zakładka HTML zawiera kod po wyrenderowaniu, więc znajdziesz w nim także treść dodaną przez skrypty, a Zrzut ekranu pokazuje stronę tak, jak zobaczył ją robot na smartfonie. Wyszukanie w kodzie fragmentu tekstu ze strony to najszybszy test, czy Google zapisał treść, o którą Ci chodzi; jak to zrobić i co z tego wynika, opisuje wpis o tym, czy Google widzi treść ładowaną przez JavaScript.
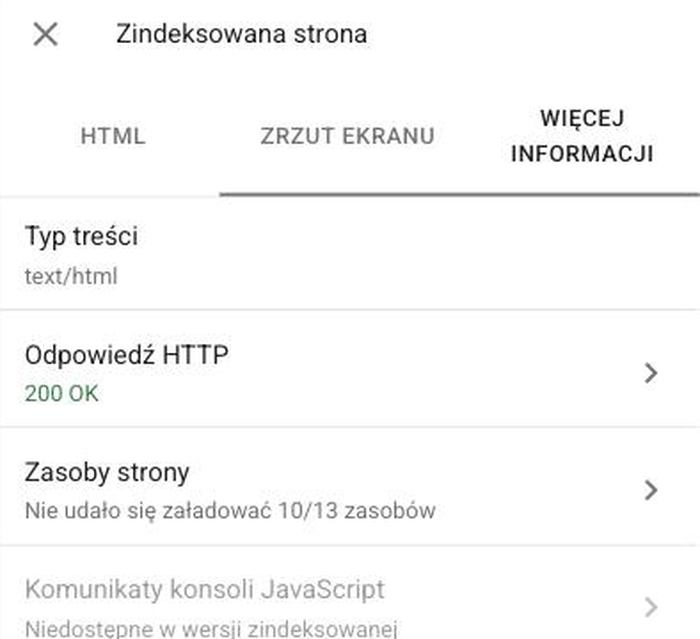
Zakładka Więcej informacji podaje typ treści, kod odpowiedzi HTTP wraz z nagłówkami i listę zasobów strony z zaznaczeniem, których Google nie załadował. Niezaładowane pliki CSS czy JavaScript sprawdzasz tylko wtedy, gdy zrzut ekranu wygląda inaczej niż strona w przeglądarce; robot nie pobiera każdego zasobu i nie każda pozycja na tej liście jest problemem. Komunikaty konsoli JavaScript są w tej wersji „Niedostępne”: dostajesz je wyłącznie w teście na żywo.
Jak działa test na żywo i czego nie sprawdza?
Przycisk Sprawdź URL wersji opublikowanej każe Google pobrać stronę teraz i ocenić, czy w tej wersji da się ją zindeksować. Test trwa od kilkunastu sekund do kilku minut, a wynik dostaje własną zakładkę „Test wersji opublikowanej” obok zakładki „Indeks Google”, więc możesz przełączać się między obiema wersjami i je porównywać.
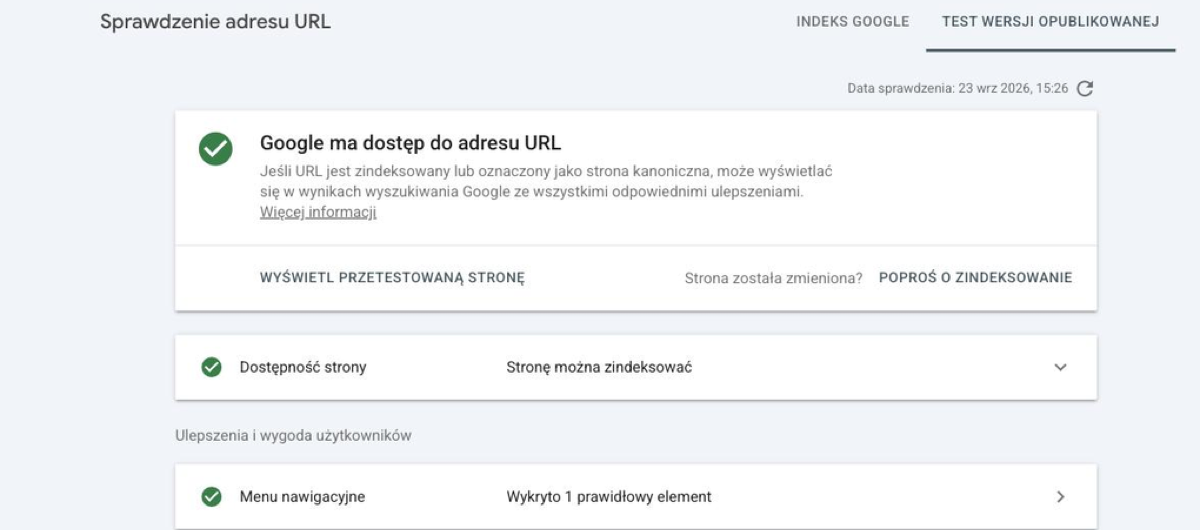
Werdykt testu brzmi inaczej niż w widoku indeksu: „Google ma dostęp do adresu URL” zamiast „znajduje się w Google”, bo test odpowiada na pytanie, czy strona nadaje się do zindeksowania, a nie czy jest zindeksowana. Kafelek Dostępność strony pokazuje wynik pobrania, a przycisk Wyświetl przetestowaną stronę otwiera ten sam panel z HTML, zrzutem i informacjami, tym razem z aktywną konsolą JavaScript. Stronę pobiera Google-InspectionTool, robot z listy głównych robotów Google, który ma własną nazwę w robots.txt: reguły skierowane tylko do niego wpływają na narzędzia testowe, a nie na indeksowanie w wyszukiwarce.
Pomoc Google wymienia wprost, czego test na żywo nie sprawdza:
- ręcznych działań, problemów bezpieczeństwa, usunięć treści z przyczyn prawnych i tymczasowych blokad, więc strona może przejść test i nadal nie pokazywać się w wynikach;
- wyboru adresu kanonicznego i duplikatów, bo Google rozstrzyga je dopiero przy właściwym indeksowaniu;
- obecności adresu w mapach witryn i na stronach odsyłających.
Test niczego nie zmienia w indeksie: możesz go powtarzać po każdej poprawce (zdjęcie noindex, naprawa przekierowania, nowa treść) i od razu widzieć efekt, a zapisana kopia zaktualizuje się dopiero po kolejnym skanowaniu przez Googlebota. Google przechowuje wynik testu przez pewien czas, dlatego przy kolejnym otwarciu tej samej karty zobaczysz datę sprawdzenia i ikonę odświeżenia.
Kiedy klikać Poproś o zindeksowanie i jaki jest limit?
Przycisk Poproś o zindeksowanie dopisuje adres do priorytetowej kolejki skanowania, a przed zgłoszeniem Google wykonuje ten sam test co na żywo, żeby odrzucić strony zablokowane albo niedostępne. Prośba przyspiesza wizytę robota, nie gwarantuje zindeksowania i nie zastępuje naprawy przyczyny, dla której strony nie ma w indeksie.
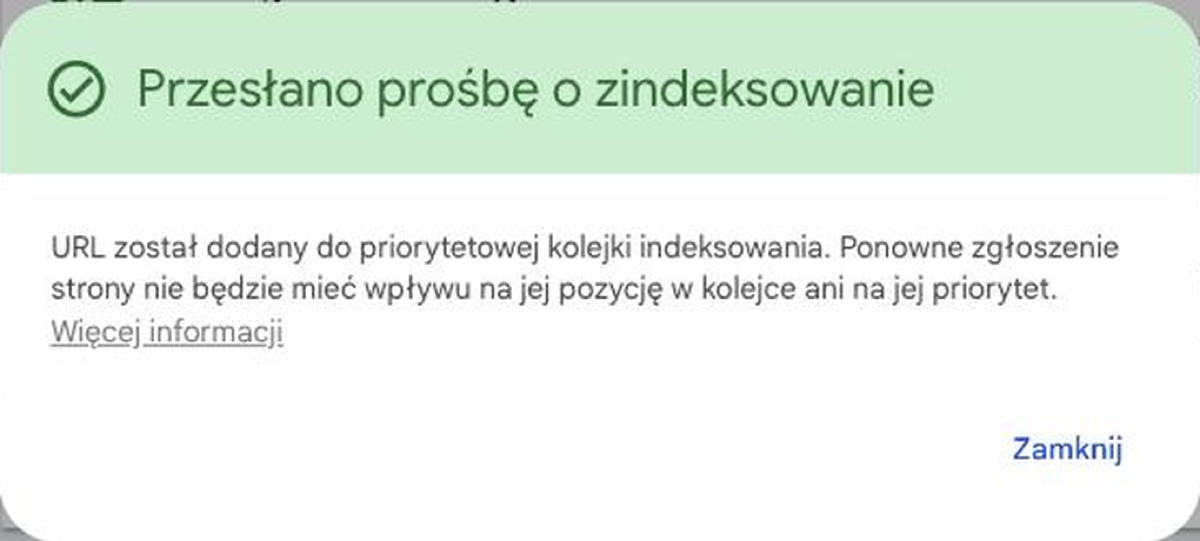
Sam komunikat mówi, że ponowne zgłoszenie tej samej strony nie zmienia jej pozycji ani priorytetu w kolejce, a Search Central dodaje, że skanowanie po zgłoszeniu może zająć od kilku dni do kilku tygodni. Zgłoszenie ma sens w trzech sytuacjach:
- nowa strona, do której nie prowadzą jeszcze linki wewnętrzne (pola Wykrywalność mają „Nie wykryto”),
- naprawiona strona, którą Google ostatnio widział jako uszkodzoną: zdjęty noindex, usunięty błąd 404, poprawione przekierowanie,
- ważna zmiana treści, gdy zależy Ci, żeby wynik w wyszukiwarce odświeżył się szybciej niż w naturalnym rytmie skanowania.
Zgłaszanie nie pomaga, gdy strona jest już zindeksowana i niezmieniona, gdy przyczyna braku w indeksie wciąż istnieje (test przed zgłoszeniem ją wykryje) ani gdy adres jest celowo wykluczony, np. strona wyników wyszukiwania w sklepie. Kilkudziesięciu nowych adresów nie zgłaszaj pojedynczo – do tego służy mapa witryny z datami modyfikacji.
Dzienny limit zgłoszeń istnieje, ale Google nie podaje jego wysokości w dokumentacji. W naszej praktyce wyczerpuje się po mniej więcej dziesięciu prośbach na jedną usługę, a odnawia się po dwudziestu czterech godzinach od zgłoszeń, nie o północy. Przy większej liczbie adresów opłaca się najpierw sprawdzić datę ostatniego skanowania: w naszej kolejce Google sam odwiedził kilkanaście procent adresów po naszej zmianie, zanim doszły do zgłoszenia, a każde takie zgłoszenie zjadłoby limit bez żadnego efektu.
Co zrobić, gdy test na żywo zwraca 403, a strona działa?
Strona otwiera się w przeglądarce z kodem 200, ale test na żywo i Poproś o zindeksowanie kończą się błędem pobrania z kodem 403 (dostęp zabroniony). Prawie zawsze znaczy to, że serwer, zapora, wtyczka bezpieczeństwa albo CDN blokuje adresy IP, z których łączą się narzędzia Google, a nie Twoich użytkowników. Google traktuje 403 jak każdy kod 4xx: nie indeksuje takich adresów, a zindeksowane wcześniej strony, które zaczynają zwracać 4xx, z czasem usuwa z indeksu.
Sprawdź kod w narzędziu.
Po nieudanym teście otwórz Wyświetl przetestowaną stronę → Więcej informacji: zobaczysz kod odpowiedzi HTTP i nagłówki, czasem z nazwą zapory, która odrzuciła żądanie. Kod 429 zamiast 403 to inny przypadek, opisany we wpisie o kodzie 429 Too Many Requests.
Sprawdź, czy blokada dotyczy też Googlebota.
W raporcie Statystyki indeksowania, w podziale według odpowiedzi, zobaczysz, jaki odsetek pobrań Googlebota kończy się kodem 403. Zero procent przy sprawnym serwerze oznacza, że blokada trafia tylko w narzędzia uruchamiane z panelu, a zwykłe skanowanie działa.
Znajdź regułę i wyłącz z niej roboty Google.
Zacznij od hostingu i pliku .htaccess, potem sprawdź wtyczkę bezpieczeństwa i ustawienia CDN. Google publikuje zakresy adresów IP swoich robotów w plikach JSON (m.in. common-crawlers.json na gstatic.com/ipranges/), więc reguła może je przepuszczać bez otwierania blokady dla wszystkich.
Z naszej praktyki: poproszony o odciążenie serwera hosting zablokował w .htaccess ruch z obu Ameryk i Azji. Narzędzia z panelu Search Console łączą się z adresów w Stanach Zjednoczonych, więc test na żywo dostawał 403. Zwykłe skanowanie przechodziło, bo Googlebot łączy się też z adresów spoza USA, i strony z mapy witryny normalnie wchodziły do indeksu. Google opisuje to w dokumentacji stron dostosowanych do lokalizacji: robota z danego kraju masz traktować jak użytkownika z tego kraju, a odcięcie regionu odcina też roboty Google, które się z niego łączą. Rozwiązaniem było wyjęcie zakresów IP Google z reguły albo przeniesienie filtrowania na CDN, który rozpoznaje roboty; do tego czasu adresy wchodziły do indeksu przez mapę witryny, a ręczne zgłaszanie nie działało.
Test na żywo pokazuje 403, a hosting mówi, że wszystko jest w porządku?
Napisz do nas, w ramach pozycjonowania stron sprawdzamy odpowiedzi serwera dla robotów Google i mówimy, którą regułę zmienić.
FAQ
Nie. Sprawdzenie adresu odczytuje zapisany stan, a test na żywo pobiera stronę tylko na potrzeby wyniku w panelu. Do indeksu strona trafia dopiero po skanowaniu przez Googlebota, które możesz przyspieszyć przyciskiem Poproś o zindeksowanie.
Według Search Central skanowanie po zgłoszeniu zajmuje od kilku dni do kilku tygodni, a zgłoszenie nie gwarantuje, że strona trafi do indeksu. Powtórne zgłoszenie tej samej strony nie zmienia jej pozycji w kolejce; jeśli po kilku tygodniach werdykt się nie zmienia, przyczynę znajdziesz w kafelku Indeksowanie stron, nie w ponownym klikaniu.
Nie. Narzędzie sprawdza wyłącznie adresy należące do usługi, w której masz uprawnienia i którą masz w danej chwili otwartą. Stan cudzej strony w indeksie sprawdzisz jedynie pośrednio, wpisując jej adres w wyszukiwarkę.
Przez URL Inspection API, które zwraca te same dane co karta w panelu (werdykt, datę ostatniego skanowania, stan pobrania i indeksowania, adresy kanoniczne) z limitem dwóch tysięcy zapytań dziennie na usługę. Panel nie ma sprawdzania hurtowego; do przeglądu całej witryny służy raport Strony.
Google uznał sprawdzany adres za główną wersję strony, zgodnie z Twoim tagiem canonical albo mimo jego braku. Gdy w tym polu jest inny adres, w wynikach wyszukiwania pokazuje się tamta strona, a sprawdzany adres Google traktuje jako jej duplikat.
Źródła
- Pomoc Google Search Console, „Narzędzie do sprawdzania adresów URL”: support.google.com/webmasters
- Google Search Central, „Ask Google to recrawl your URLs”: developers.google.com/search
- Google Search Central, „Google’s common crawlers” (Google-InspectionTool): developers.google.com/search
- Google Search Central, „Verifying Googlebot and other Google crawlers” (listy IP): developers.google.com/search
- Google Search Central, „Locale-adaptive pages” (Googlebot z adresów spoza USA): developers.google.com/search
- Google Search Central, „HTTP status codes, network and DNS errors” (kody 4xx): developers.google.com/search
- Search Console API, „Usage limits” (URL Inspection API): developers.google.com/webmaster-tools

