Plik robots.txt to plik tekstowy umieszczony w katalogu głównym domeny (https://domena.pl/robots.txt), w którym właściciel strony zapisuje reguły dla robotów wyszukiwarek: które adresy robot może pobierać, a które ma pomijać. Googlebot odczytuje go przed pobraniem pierwszej strony z witryny. Plik ogranicza wyłącznie pobieranie (crawlowanie), nie usuwa adresów z indeksu Google i nie chroni treści przed dostępem osób, bo każdy może go otworzyć w przeglądarce.
Czym jest plik robots.txt i gdzie się znajduje?
Plik robots.txt to plik tekstowy (UTF-8), dostępny pod dokładnie jednym adresem: https://domena.pl/robots.txt, w katalogu głównym hosta. Plik w podkatalogu (/blog/robots.txt) nie działa, a każdy host i protokół ma własny plik: reguły z https://roseo.com.pl/robots.txt nie obowiązują dla subdomeny.
Format pliku opisuje Robots Exclusion Protocol (RFC 9309, 2022), a zachowanie Googlebota rozstrzyga dokumentacja Google. Kod odpowiedzi serwera na żądanie /robots.txt ma znaczenie: przy 200 plik jest stosowany, przy 404 Google przyjmuje brak ograniczeń i pobiera całą witrynę, a przy błędzie 5xx wstrzymuje pobieranie witryny i dopiero po 30 dniach bez poprawy korzysta z ostatniej zapisanej kopii pliku.
Jak wygląda składnia pliku robots.txt?
Składnia to grupy reguł: każda grupa zaczyna się od linii User-agent i zawiera reguły Disallow i Allow, jedna reguła w jednej linii. Tak wygląda plik robots.txt na roseo.com.pl:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://roseo.com.pl/sitemap_index.xml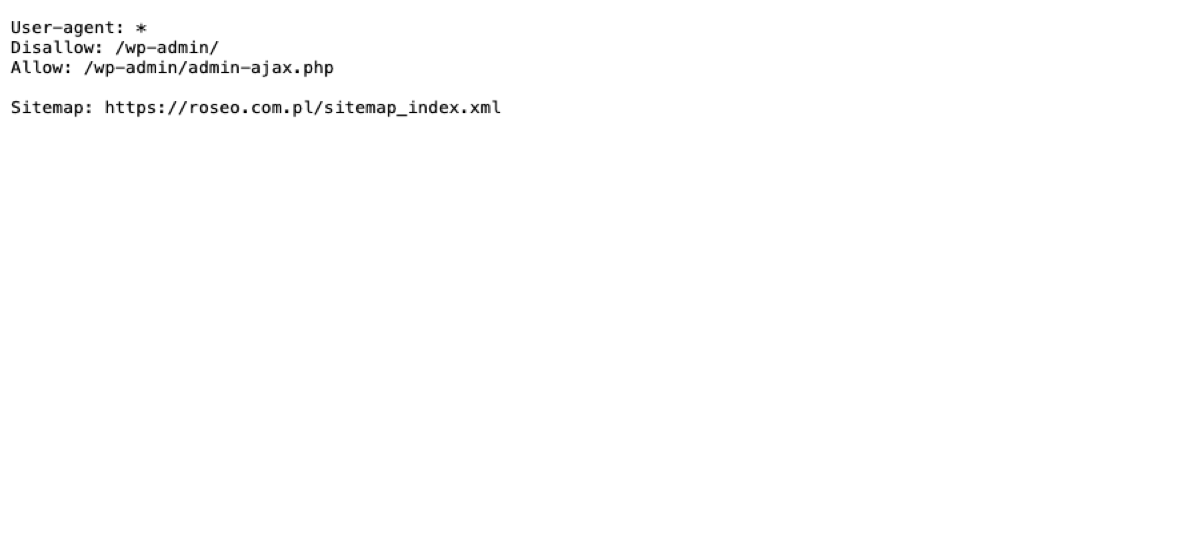
Ten plik zawiera jedną grupę dla wszystkich robotów: blokuje panel administracyjny WordPressa i odsłania w nim jeden plik, admin-ajax.php, z którego korzystają skrypty widoczne na stronie (formularze, filtry). Na końcu wskazuje mapę witryny. To domyślna treść, którą WordPress generuje sam, gdy na serwerze nie ma fizycznego pliku; linię Sitemap dodaje wtyczka SEO, na roseo.com.pl Rank Math.
Dyrektywy, które rozumie Googlebot:
- User-agent: <nazwa>: do którego robota stosują się kolejne reguły. Gwiazdka oznacza wszystkie roboty,
Googlebotwyszukiwarkę Google,Googlebot-Imagerobota grafiki. Robot stosuje tylko grupę najdokładniej dopasowaną do swojej nazwy. - Disallow: <ścieżka>: ścieżka, której robot ma nie pobierać. Ścieżka zaczyna się od
/i rozróżnia wielkość liter:/Blog/to inny adres niż/blog/. Pusta wartość (Disallow:) nie blokuje niczego, aDisallow: /blokuje całą witrynę. - Allow: <ścieżka>: wyjątek od
Disallow. Gdy obie reguły pasują do adresu, obowiązuje ta z dłuższą ścieżką. - Sitemap: <pełny adres>: lokalizacja mapy witryny XML. Adres musi być pełny (z
https://), linii może być kilka i nie muszą stać w żadnej grupie. - #: początek komentarza, robot pomija resztę linii.
- Wieloznaczniki: gwiazdka zastępuje dowolny ciąg znaków (
Disallow: /*?sort=blokuje każdy adres z parametremsort), znak dolara oznacza koniec adresu (Disallow: /*.pdf$blokuje pliki PDF, ale nie adres/plik.pdf?v=2).
Google czyta najwyżej 500 KiB pliku, a reguł spoza tej listy (Crawl-delay, noindex) nie stosuje.
Blokowanie w Disallow plików CSS i JavaScript potrzebnych do wyrenderowania strony bywa błędem: bez nich Google ocenia stronę tak, jak wygląda bez nich. O renderowaniu JavaScript piszemy w osobnym wpisie.
Do czego służy robots.txt w praktyce?
Robots.txt służy do tego, żeby robot nie wydawał żądań na adresy, które nie mają trafić do wyszukiwarki: panel logowania, katalogi techniczne, wyniki wyszukiwarki wewnętrznej, adresy z parametrami sortowania i filtrowania, wersje do druku. Każde pominięte żądanie zostaje dla stron, które mają być w indeksie, dlatego robots.txt jest jednym z narzędzi zarządzania crawl budgetem.
Przykład ogólny: blokada wyników wyszukiwarki wewnętrznej i katalogu z plikami tymczasowymi, z komentarzem:
# wyszukiwarka wewnetrzna i pliki tymczasowe
User-agent: *
Disallow: /szukaj/
Disallow: /tmp/
W sklepie internetowym najwięcej reguł dotyczy filtrów i parametrów adresu; konkretne reguły dla WooCommerce są we wpisie o optymalizacji crawl budgetu w sklepie internetowym.
Nie wiesz, co robot pomija na Twojej stronie?
Sprawdzimy plik robots.txt i raporty Search Console.
Czego robots.txt nie robi?
Robots.txt nie usuwa strony z indeksu Google i nie zabezpiecza treści przed dostępem. Blokuje wyłącznie pobranie adresu przez robota.
Adres zablokowany w robots.txt, do którego prowadzą linki z innych stron, Google może zindeksować i pokazać w wynikach bez opisu: z samym adresem albo z tytułem wziętym z tekstu linku. W raporcie Strony w Search Console taki adres ma status „Zindeksowano, ale zablokowano przez plik robots.txt”. Do usunięcia strony z indeksu służy znacznik noindex w kodzie strony lub w nagłówku HTTP X-Robots-Tag, a doraźnie narzędzie Usunięcia w Search Console, które ukrywa adres na około sześć miesięcy. Strona jednocześnie zablokowana w robots.txt i oznaczona noindex zostaje w indeksie, bo robot jej nie pobiera i nie widzi znacznika.
| Mechanizm | Gdzie zapisany | Co robi | Czy usuwa z indeksu |
|---|---|---|---|
| Disallow | robots.txt | zakazuje robotowi pobrania adresu | nie; adres z linkami może zostać zindeksowany bez treści |
| Allow | robots.txt | odblokowuje adres wewnątrz zablokowanego katalogu | nie dotyczy; pozwala na pobranie |
| noindex | kod strony (meta robots) lub nagłówek HTTP | pozwala pobrać stronę, zakazuje jej indeksowania | tak, po kolejnym pobraniu strony przez robota |
Robots.txt nie jest też zabezpieczeniem: to instrukcja respektowana przez roboty wyszukiwarek (Googlebot, Bingbot), a program, który ją zignoruje, pobierze zablokowane adresy i odczyta z listy Disallow, gdzie szukać. Treści wymagające ochrony zabezpiecza hasło lub uprawnienia na serwerze.
Jak sprawdzić własny plik robots.txt?
Plik sprawdza się w dwóch miejscach: w przeglądarce pod adresem https://domena.pl/robots.txt i w raporcie robots.txt w Search Console (Ustawienia → robots.txt). Raport pokazuje datę ostatniego pobrania, kod odpowiedzi, rozmiar oraz ostrzeżenia i błędy składni z numerami linii; po zmianie można z niego poprosić o ponowne pobranie, bez tego Google odświeża kopię najpóźniej po 24 godzinach.
Czy konkretny adres jest zablokowany, pokazuje narzędzie Sprawdzenie adresu URL (informacja o pobieraniu strony z odpowiedzią „zablokowany przez plik robots.txt”), a w raporcie Strony filtr statusu „Zablokowana przez plik robots.txt”.
Zmiana w robots.txt zablokowała coś, czego nie powinna?
Ustalimy, które adresy robot pomija i co poprawić.
FAQ
Nie. Brak pliku (kod 404) Google traktuje jak brak ograniczeń i pobiera wszystkie adresy, do których dotrze. Plik ma zastosowanie, gdy jest coś do wyłączenia z pobierania albo trzeba wskazać mapę witryny.
Tak. Linia „Disallow: /” zakazuje pobierania wszystkich adresów danej grupie robotów, a od samego „Disallow:” (brak blokady) różni się jednym znakiem. Po każdej edycji plik sprawdza się w raporcie robots.txt w Search Console i narzędziem Sprawdzenie adresu URL na stronie głównej.
Tak, tą samą składnią: osobna grupa „User-agent: GPTBot” z „Disallow: /” dotyczy robota OpenAI, a „User-agent: Google-Extended” decyduje o wykorzystaniu treści w modelach Gemini i nie wpływa na obecność strony w wyszukiwarce Google. Blokada działa dla robotów, których operator deklaruje przestrzeganie pliku.
Nie. Google od 1 września 2019 r. pomija regułę noindex w robots.txt, tak samo jak nofollow i crawl-delay. Znacznik noindex działa tylko w kodzie strony lub w nagłówku HTTP, na stronie, którą robot może pobrać.
Źródła
- Google Search Central, „Plik robots.txt – wprowadzenie i przewodnik”: developers.google.com
- Google Search Central, „Tworzenie i przesyłanie pliku robots.txt”: developers.google.com
- Google Search Central, „Jak Google interpretuje specyfikację pliku robots.txt”: developers.google.com
- Pomoc Google Search Console, „Raport dotyczący pliku robots.txt”: support.google.com/webmasters
- IETF, RFC 9309 „Robots Exclusion Protocol”: rfc-editor.org/rfc/rfc9309